Yapay Zekânın Kötüye Kullanımı Yeni Bir Eşiğe Geldi: Biyolojik Araştırmadan Siber Saldırılara Uzanan Risk Haritası Büyüyor
 Tepki Ver
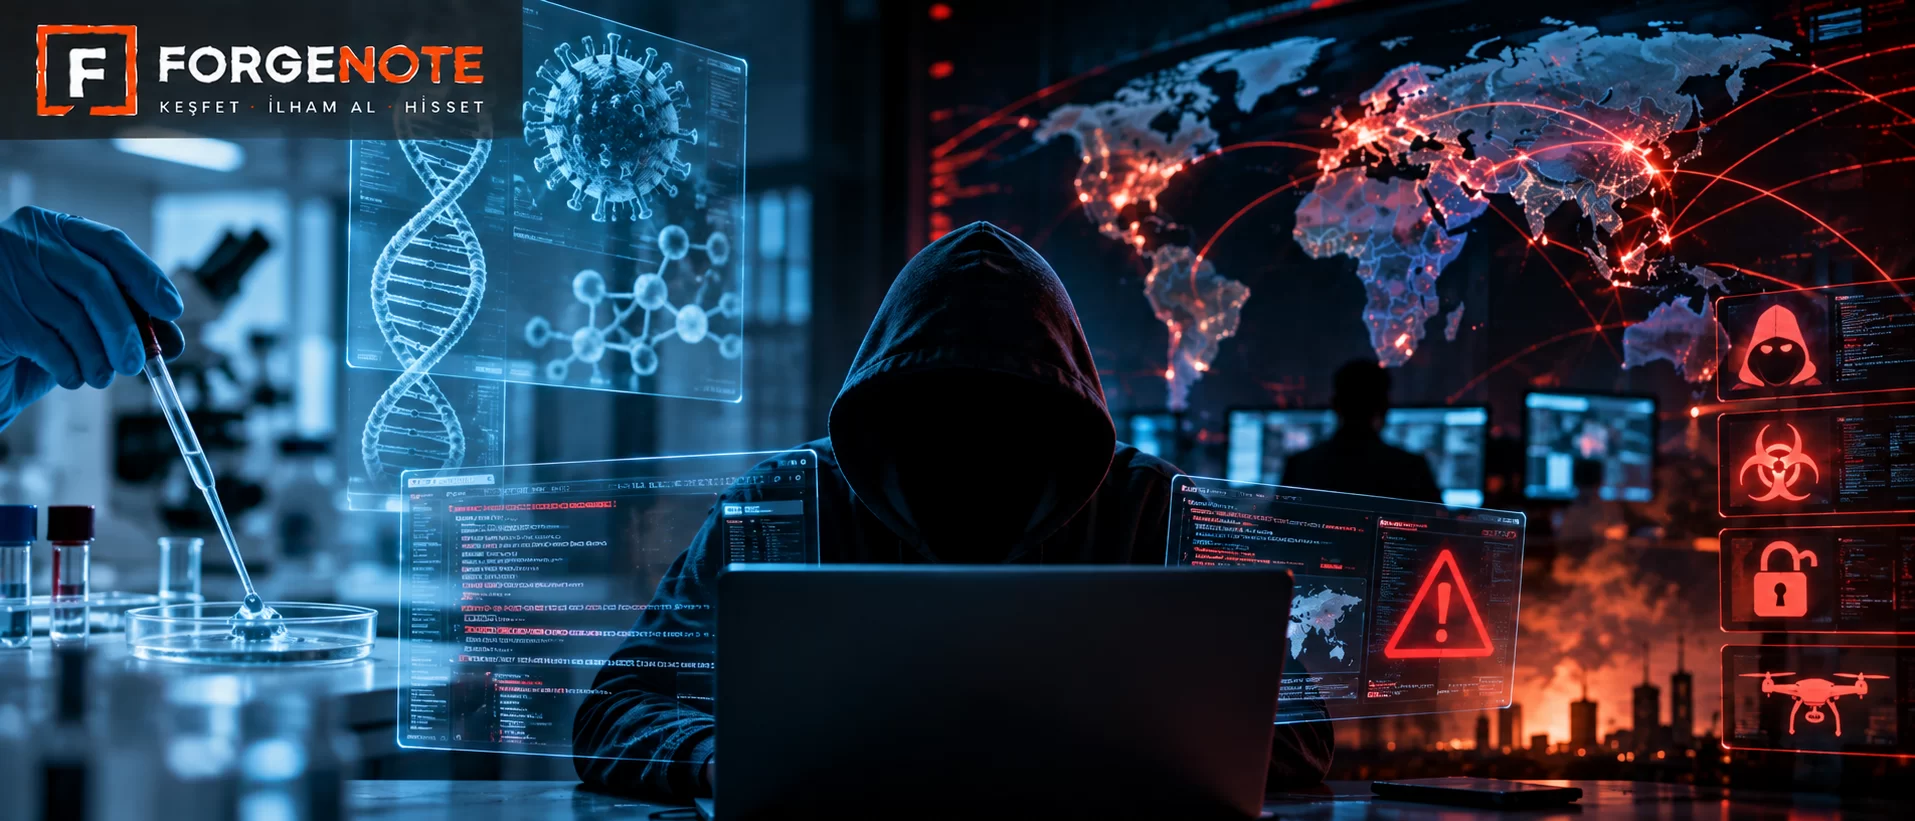
Yapay zekâ daha güçlü hale geldikçe kötüye kullanım ihtimalleri de çeşitleniyor. Siber saldırıların hızlandırılmasından hassas biyolojik araştırmalara verilen desteğe kadar uzanan riskler, AI güvenliğinin artık yalnızca yanlış bilgi veya dolandırıcılıktan ibaret olmadığını gösteriyor. Yeni tartışma, yetenekler büyürken güvenlik önlemlerinin aynı hızda gelişip gelişemeyeceği.
Yapay zekânın güvenliği tartışılırken uzun süre yanlış bilgi, sahte görüntüler ve dolandırıcılık konuşuldu. Şimdi risk haritasına çok daha ciddi alanlar ekleniyor.
Anthropic’in 10 Eylül 2026’da yayımladığı yeni tehdit raporu, Claude modellerinin son sekiz ayda siber saldırılar, gözetim, dolandırıcılık, propaganda, silah geliştirme ve riskli biyolojik araştırmalarda kullanılmaya çalışıldığı vakaları ortaya koydu. Şirket söz konusu faaliyetleri tespit ederek hesapları kapattığını ve güvenlik sistemlerini güçlendirdiğini açıkladı.
Buradaki önemli değişim kötü niyetli insanların yapay zekâyı keşfetmesi değil. Modellerin giderek daha karmaşık görevlerde işe yarayabilecek seviyeye ulaşması.
Biyoloji neden en hassas alanlardan biri?
Yapay zekânın biyolojide olağanüstü bir potansiyeli var. İlaç araştırmalarından genom analizine kadar bilim insanlarının yıllar sürebilecek çalışmalarını hızlandırabiliyor.
Fakat aynı bilgi çift kullanımlı olabilir.
Anthropic, raporunda biyolojik silah geliştirmeyi destekleyebilecek nitelikte beş kullanım vakası tespit ettiğini açıkladı. Bunlardan birinde bir araştırmacı kuş gribinin memelilere uyum sağlamasıyla ilgili deneylerin planlanmasında Claude’dan yararlanmaya çalıştı. Başka bir vakada ise chikungunya virüsü üzerinde riskli bir araştırma programıyla bağlantılı kullanım görüldü.
Burada önemli bir ayrıntı var: Anthropic, incelenen olaylarda Claude’un tehlikeli biyolojik araştırmaları tek başına mümkün hale getirdiğini söylemiyor. Şirket, özellikle daha zayıf modellerin sağladığı katkının ağırlıklı olarak veri analizi, araştırma fikri geliştirme ve deney planlamasında sınırlı kaldığını belirtiyor. Güçlü modellerdeki biyogüvenlik filtreleri ise daha riskli taleplerin önemli bölümünü engelledi.
Endişe daha çok gelecekle ilgili.
Modeller bilimsel araştırmada güçlendikçe faydalı biyoloji ile tehlikeli biyoloji arasındaki çizgiyi otomatik olarak ayırmak zorlaşıyor.
Siber dünyada eşik daha hızlı değişiyor
Siber güvenlikte dönüşüm daha görünür.
Yeni nesil AI sistemleri yalnızca kötü amaçlı kod yazmaya yardım etmiyor. Güvenlik açığı aramak, hedef hakkında bilgi toplamak ve çok aşamalı operasyonların bazı bölümlerini yürütmek gibi görevlerde giderek daha yetenekli hale geliyor.
Anthropic’in raporu, Rusya bağlantılı devlet destekli aktörlerden başka ülkelerdeki operasyonlara kadar çeşitli grupların Claude’u siber faaliyetlerde kullanmaya çalıştığını gösteriyor. Şirket ayrıca modellerin silah yazılımları, istihbarat toplama ve gözetim gibi alanlarda kötüye kullanılmaya çalışıldığı vakalar tespit etti.
Bu hafta yayımlanan Bank for International Settlements değerlendirmesi de frontier modellerin kritik güvenlik açıklarını bulma, istismar kodları geliştirme ve giderek karmaşıklaşan çok aşamalı siber operasyonları otomatikleştirme kapasitesine dikkat çekiyor. Bunun sonucu saldırı için gereken uzmanlık, zaman ve kaynak miktarının azalması olabilir.
Başka bir ifadeyle AI yalnızca saldırganı daha güçlü yapmıyor.
Saldırı yapabilmenin giriş eşiğini de düşürebilir.
Savunma tarafı da aynı teknolojiye sahip
Tablonun yalnızca karanlık bir tarafı yok.
Bir model güvenlik açığını saldırgandan önce bulabiliyorsa aynı yetenek savunma için de kullanılabilir. Yazılımlar otomatik taranabilir, şüpheli faaliyetler daha hızlı tespit edilebilir ve saldırı başladıktan sonra müdahale süresi kısalabilir.
Nitekim BIS de frontier AI’ın tehdit tespiti, güvenlik açığı keşfi ve olaylara müdahalede önemli savunma fırsatları sunduğunu vurguluyor.
Bu nedenle AI güvenliğinin temel problemi teknolojinin “iyi” veya “kötü” olması değil.
Aynı kapasitenin iki taraf tarafından da kullanılabilmesi.
Bir sistem yeni bir yazılım açığını keşfedebiliyorsa bunu savunmacı da saldırgan da isteyebilir. Bir model karmaşık biyolojik araştırmaları hızlandırabiliyorsa aynı bilgi faydalı bilimsel araştırmalarda olduğu kadar tehlikeli amaçlarda da değer taşıyabilir.
Bu, çift kullanım problemi olarak bilinen eski bir meselenin yapay zekâ çağındaki yeni biçimi.
Güvenlik artık yalnızca cevapları filtrelemek değil
Bugüne kadar AI güvenliği çoğunlukla modelin belirli sorulara cevap vermesini engellemek üzerinden düşünüldü.
Yeni vakalar bunun tek başına yeterli olmayabileceğini gösteriyor.
Anthropic’in tespit ettiği bazı kullanıcılar amaçlarını gizlemeye, farklı hesaplar ve aracılar kullanmaya veya taleplerini daha küçük parçalara bölmeye çalıştı. Şirket de bu nedenle yalnızca içerik filtrelerine değil, hesapların kimliğine, kullanım davranışlarına ve kurumsal güvenilirliğe dayanan ek kontrollerin özellikle ileri biyoloji gibi alanlarda gerekli olabileceğini söylüyor.
Bu yaklaşım gelecekte güçlü AI sistemlerine erişimi değiştirebilir.
Gündelik bir sohbet modeli herkese açık kalırken çok gelişmiş biyoloji veya siber güvenlik yetenekleri yalnızca doğrulanmış araştırmacılara, şirketlere veya kamu kurumlarına sunulabilir.
Nitekim sektör bu yönde hareket etmeye başladı. Frontier Model Forum da biyoloji ve ileri siber risklerde olay paylaşımı, güvenlik değerlendirmeleri ve erişim kontrollerinin giderek önem kazandığını belirtiyor.
Asıl değişim kapasitenin büyümesi
Bugünkü veriler “AI biyolojik silah yapıyor” veya “siber saldırıları tamamen kendi başına gerçekleştiriyor” gibi bir sonuca izin vermiyor.
Fakat daha önemli bir gelişme var.
Yapay zekâ modelleri daha önce yalnızca uzman insanların yapabildiği bazı karmaşık görevlerde giderek daha kullanışlı hale geliyor. Anthropic’in yeni değerlendirmeleri de bazı askeri ve istihbarat görevlerinde modellerin geçmişte az sayıdaki eğitimli uzmanın yapabildiği işleri yerine getirebildiğini gösteriyor.
Bu yüzden yapay zekâ güvenliğinin geleceği yalnızca yanlış cevapları azaltmakla ilgili olmayacak.
Kimlerin en güçlü modellere erişebileceği, modellerin hangi araçları kullanabileceği, şüpheli faaliyetlerin nasıl tespit edileceği ve şirketlerin ciddi olayları birbirleriyle ne kadar hızlı paylaşacağı da aynı derecede önemli hale gelecek.
Yapay zekâ güçlendikçe eski güvenlik sorusu değişiyor.
Artık yalnızca “Model ne söyleyebilir?” diye sormak yeterli değil.
Asıl soru giderek şu hale geliyor:
“Bu model, yanlış kişinin elinde ne yapabilir?”